Як скачати сайт з вебархіву
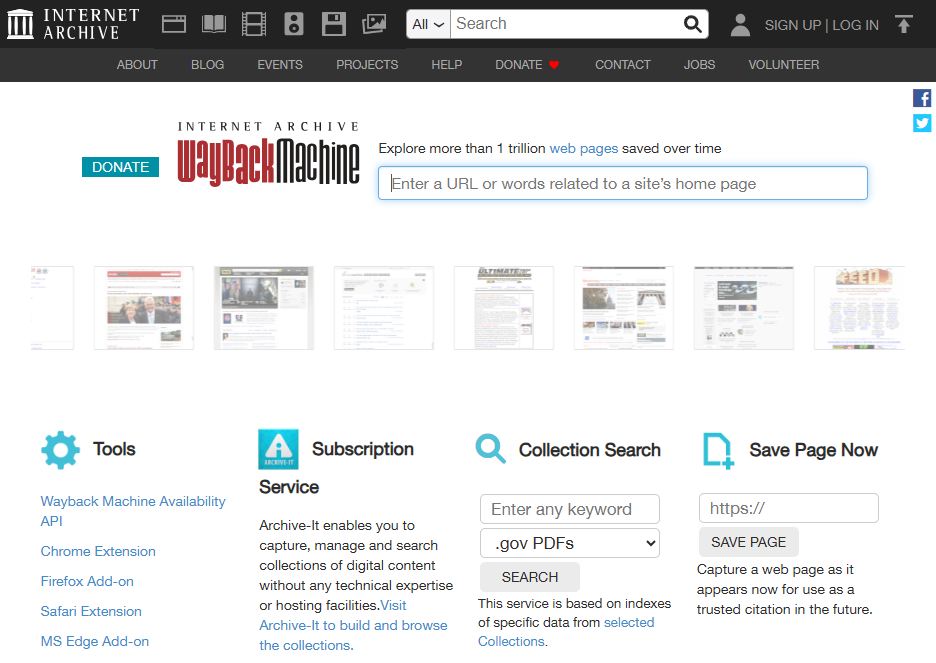
Сайт з Вебархіву можна завантажити повністю: сторінки, зображення, стилі й скрипти у тому вигляді, в якому їх зберіг робот Internet Archive. Знадобиться безкоштовна утиліта на Ruby або Python-скрипт, кілька команд у терміналі й терпіння, бо archive.org обмежує частоту запитів.
Wayback Machine відкрили для публіки 25 жовтня 2001 року, засновники Брюстер Кейл і Брюс Гіліат. У жовтні 2025 року архів перетнув позначку в один трильйон збережених вебсторінок, обсяг сховища на той момент перевищував 99 петабайт. Тому з великою ймовірністю там лежить і сайт, який вас цікавить: проєкт, що закрився, ресурс з простроченим доменом, старий сайт клієнта без резервної копії.
На SiteHub ми регулярно працюємо з доменами, що звільнилися, і відновлення контенту з архіву для нас звична процедура. Нижче описано два робочі способи з командами, перевіреними на реальному сайті, і розбір помилок, які трапляються найчастіше.
Як Вебархів зберігає сайти
Кожне відвідування сторінки роботом архіву дає окремий знімок з міткою часу у форматі РРРРММДДггххсс. Саме ця мітка стоїть в адресі на кшталт web.archive.org/web/20240930153212/https://example.com/. Сайт у архіві зберігається як набір окремих файлів, кожен зі своєю історією знімків. Тому дати знімків різних файлів одного сайту часто не збігаються: головну сторінку робот міг зберегти сотні разів, картинку в підвалі сайту один раз у 2019 році.
Список усіх знімків видає CDX API за адресою web.archive.org/cdx/search/cdx. Запит з параметром url=example.com/* повертає кожну збережену адресу домену з датою, MIME-типом і HTTP-статусом відповіді. Параметри from і to обмежують період, filter=statuscode:200 відсікає редиректи й помилки. Усі інструменти для завантаження сайтів з архіву працюють через цей API.
Щоб отримати файл у первісному вигляді, до мітки часу додають суфікс id_: web.archive.org/web/20240930153212id_/https://example.com/. Без нього архів вставляє в HTML власну панель навігації, скрипти й переписує всі посилання на свої адреси. Для відновлення сайту потрібна саме версія з id_.
Враховуйте обмеження. Archive.org працює як некомерційна організація на обмежених серверах і при частих запитах віддає помилки 429 і 503. У жовтні 2024 року після DDoS-атаки сайт лежав з 9 по 14 жовтня і ще до 4 листопада працював у режимі лише читання. Власник сайту може попросити видалити його з архіву, такі запити Internet Archive виконує з квітня 2017 року, тому частина доменів недоступна взагалі.
Wayback Machine Downloader на Ruby
Найвідоміший інструмент для цієї задачі називається Wayback Machine Downloader, його автор розробник під ніком hartator. Репозиторій має близько 5,9 тисячі зірок на GitHub, гем завантажили понад 370 тисяч разів. Остання версія 2.3.1 вийшла 4 вересня 2021 року, відтоді проєкт не оновлювався.
З нашого досвіду на Windows стабільно працює Ruby гілки 2.4. З версіями 3.x бібліотека поводиться нестабільно, з дуже старими збірками на кшталт 1.9.2 падає на першому ж запиті. Перевірені інсталятори:
Під час встановлення залиште увімкненою опцію додавання Ruby до PATH. Якщо на комп'ютері вже стоїть інша версія, видаліть її або приберіть її папку bin зі змінної PATH, щоб команда ruby не запускала стару збірку. Відкрийте новий командний рядок (на Windows: Win+R > ввести cmd > Enter), переконайтеся, що ruby -v показує 2.4, і встановіть гем:
gem install wayback_machine_downloader
wayback_machine_downloader https://example.com --to 20240930153212
Утиліта збереже сайт у папку websites\example.com всередині поточної директорії, для C:\Users\Ім'я це буде C:\Users\Ім'я\websites\example.com. Іншу папку задає параметр -d. Параметри --from і --to приймають дату повністю або частково: 2021, 202109, 20210904. Параметр --only з регулярним виразом обмежує завантаження потрібним розділом, --exclude пропускає зайве, -c 4 вмикає чотири паралельні потоки. Потоки краще не збільшувати, на більших значеннях архів швидко починає відповідати помилками.
Помилки під час завантаження і як їх усунути
Повідомлення bad URI(is not URI?) з посиланням на файл uri/common.rb у шляху C:/Ruby192/... означає застарілий Ruby. Версія 1.9.2 вийшла у 2010 році, її парсер адрес не розуміє запит до CDX API, вбудований OpenSSL також не підтримує протоколи шифрування, які сьогодні вимагає archive.org. Рішення одне: встановити Ruby 2.4 за посиланнями вище і прибрати стару версію з PATH.
Помилка 503 Service Unavailable (OpenURI::HTTPError) у файлі archive_api.rb з'являється вже на робочому Ruby. Це відповідь сервера CDX, який у цей момент перевантажений або обмежує ваш IP. Утиліта на Ruby не повторює запит і завершує роботу при першій такій відповіді. Буває досить почекати 15–30 хвилин і запустити команду знову. Для великих сайтів з тисячами сторінок 503 трапляється майже гарантовано, тому для них ми написали власний скрипт з автоматичними повторами.
Порожня папка після завершення роботи зазвичай пов'язана з датами. Якщо в --to вказано момент раніше першого знімка домену, API поверне порожній список. Перевірте календар знімків на сторінці web.archive.org/web/*/example.com і скоригуйте період. Друга причина порожнього результату: власник домену подав запит на виключення сайту з архіву, тоді на сторінці знімків з'явиться відповідне повідомлення.
Python-скрипт від SiteHub
Скрипт wayback_downloader.py працює на Windows, macOS і Linux, потребує лише Python 3.7 або новішого і не використовує сторонніх бібліотек.
Він робить ту саму роботу, що й утиліта на Ruby, з кількома відмінностями. На помилки 429 і 503 скрипт реагує паузою, яка зростає з 5 секунд до 3 хвилин, і повторює запит. Список знімків запитується порціями по 50 000 записів через механізм resumeKey, тому навіть великі сайти не впираються в тайм-аут API. Для кожної адреси береться найсвіжіший знімок у заданому періоді. Список зберігається в кеш _cdx.json і в таблицю _list.csv з прямими посиланнями на знімки, яку зручно відкрити в Excel. Перерване завантаження продовжується з того самого місця, адреси з помилками записуються в _failed.txt і повторюються при наступному запуску.
На Windows спершу перевірте наявність Python командою python --version у командному рядку. Якщо команду не знайдено, встановіть Python з python.org/downloads і на першому екрані інсталятора поставте галочку «Add python.exe to PATH». Потім покладіть скрипт у зручну папку, перейдіть у неї і запустіть:
python wayback_downloader.py example.com --to 20240930153212Домен вказується без https:// і www, скрипт сам прибирає ці частини. Файли збережуться в папку з назвою домену поруч зі скриптом. Додаткові параметри:
--fromі--toобмежують період знімків, формат дати від2019до20190515120000;--out назва_папкизадає папку для збереження;--only-htmlзавантажує тільки сторінки без зображень, CSS і JS, це в кілька разів швидше;--onlyі--excludeприймають регулярний вираз для відбору адрес, наприклад--exclude "\?|/tag/"пропустить сторінки з параметрами і теги;--subdomainsдодає піддомени, кожен потрапить у власну папку;--rewrite-linksпереписує абсолютні посилання на домен у відносні для перегляду копії офлайн;--pause 3збільшує паузу між файлами, типове значення 1,5 секунди;--list-onlyлише збирає список адрес у_list.csvбез завантаження файлів;--refreshзаново запитує список знімків замість кешу.
З паузою 1,5 секунди скрипт завантажує приблизно 2000 файлів за годину. Сайт на 500 сторінок з картинками зазвичай вкладається у 2–3 години, з --only-html у 15–20 хвилин. Розділ сайту завантажується так само, достатньо вказати шлях: python wayback_downloader.py example.com/blog/.
Перегляд і використання завантаженої копії
HTML-файли з архіву містять абсолютні посилання на кшталт https://example.com/style.css. Якщо відкрити index.html подвійним кліком, браузер шукатиме стилі й картинки на живому домені, і сторінка може виглядати розбитою. Для повноцінного перегляду завантажте сайт з параметром --rewrite-links і запустіть локальний сервер, вбудований у Python:
cd example.com python -m http.server 8000Після цього копія сайту відкриється в браузері за адресою http://localhost:8000. Сторінки з параметрами в адресі, як-от index.php?route=product/category&path=20, скрипт зберігає під іменами на зразок index__route_product_category_path_20.php.html, тому внутрішні посилання на них локально не спрацюють. Для розбору тексту, структури й мета-тегів це значення не має.
Динамічні частини сайту архів не зберігає. Пошук, кошик, форми зворотного зв'язку, особистий кабінет і все, що генерується через PHP та базу даних, у копії працювати не буде. Ви отримуєте статичний HTML, з якого можна витягнути тексти, зображення, структуру меню й URL сторінок. Для відновлення сайту на CMS цей контент переносять вручну або скриптом імпорту, зберігаючи старі адреси сторінок, щоб не втратити накопичені пошукові позиції й зовнішні посилання.
Окреме питання стосується прав на контент. Тексти й зображення в архіві належать їхнім авторам, факт збереження в Wayback Machine права на них не передає. Відновлювати власний сайт або сайт клієнта за його згодою можна вільно. Купуючи домен, що звільнився, перевіряйте історію через архів ще до покупки: на SiteHub цей крок входить у стандартну перевірку домену, бо колишній дорвей чи сайт з піратським контентом залишає слід у пошукових системах на роки.
